Tester un agent IA, c’est évaluer un comportement : la tâche accomplie, le chemin suivi et les décisions prises en route. La méthode combine un jeu de tâches de référence, l’analyse des traces d’exécution, des notes graduées et une supervision humaine, elle-même testée.
Un agent IA ne se contente plus de répondre. Il planifie, appelle des outils et enchaîne des actions sans attendre d’instruction. Vos cas de test classiques ne suffisent plus à le valider.
Julien Van Quackebeke, CEO d’All4test, a présenté une méthode dédiée à la Soirée du Test Logiciel de Sophia-Antipolis, le 15 septembre 2026 (compte rendu de la conférence). Cet article la transforme en plan d’action : cinq étapes, les métriques à suivre, le stress test, la supervision humaine, les règles de 2026 et deux retours d’expérience chiffrés.
Qu’est-ce qu’un agent IA, du point de vue du testeur ?
Un agent IA réunit quatre briques : un modèle de langage (LLM) qui raisonne, une mémoire, des outils et des garde-fous. Le LLM planifie la tâche et choisit l’action suivante. Les outils lui donnent prise sur le système : API, navigateur, fichiers, logiciels tiers. La mémoire conserve l’historique des actions et lui permet de progresser. Les garde-fous fixent ses limites et les moments où il doit demander l’accord de l’utilisateur.
Chaque brique ouvre une source de défaut. L’agent peut choisir le mauvais outil, lui transmettre un paramètre erroné, perdre le fil de la tâche ou franchir une limite. Nous avons présenté les agents qui assistent les testeurs dans Agents IA en test logiciel : cas d’usage et bénéfices. Cet article traite l’autre face : l’agent devient l’objet du test.
Pourquoi les tests classiques ne suffisent-ils plus ?
Une application classique est déterministe : les mêmes entrées produisent les mêmes sorties. Le testeur compare le résultat obtenu au résultat attendu, et le verdict tombe. Un agent IA remet en cause ce principe sur quatre points :
- le non-déterminisme : une même demande produit plusieurs réponses acceptables ;
- l’oracle de test : sans résultat attendu unique, le verdict demande une autre méthode ;
- l’action par étapes : une bonne réponse finale peut cacher un mauvais chemin ;
- l’évolution du comportement : l’agent apprend, et sa version de demain ne réagira pas comme celle d’aujourd’hui.
| Application classique | Agent IA | |
|---|---|---|
| Comportement | Déterministe | Non déterministe |
| Ce que le test vérifie | Un résultat attendu précis | Un comportement acceptable |
| Niveaux de test | Composant, intégration, système, acceptation | Tâche de bout en bout, trajectoire, composants |
| Verdict | Réussi ou échoué | Note graduée, sur plusieurs exécutions |
Le test d’un agent porte sur son comportement complet : le résultat, le chemin et les décisions.
Vos équipes doivent valider un agent avant sa mise en production ? Un coach IA d’All4test les accompagne sur un projet pilote pour mettre en place ces pratiques.
Que mesurer quand les réponses changent à chaque exécution ?
Les réponses d’un agent varient d’une exécution à l’autre. Sa qualité reste mesurable sur quatre piliers.
| Pilier | Question posée | Exemples de métriques |
|---|---|---|
| Efficacité | L’agent a-t-il accompli la tâche voulue par l’utilisateur ? | Taux de réussite des tâches, exactitude par rapport à l’intention |
| Efficience | À quel prix ? | Nombre d’étapes, latence, coût par tâche |
| Robustesse | Comment réagit-il à l’imprévu ? | Nouvelles tentatives, dégradation progressive, questions de clarification |
| Sécurité et alignement | Respecte-t-il les règles ? | Conformité aux politiques, confidentialité, résistance à l’injection de prompt |
Ces quatre piliers servent de grille de lecture à chaque étape de la méthode.
Comment tester un agent IA en 5 étapes ?
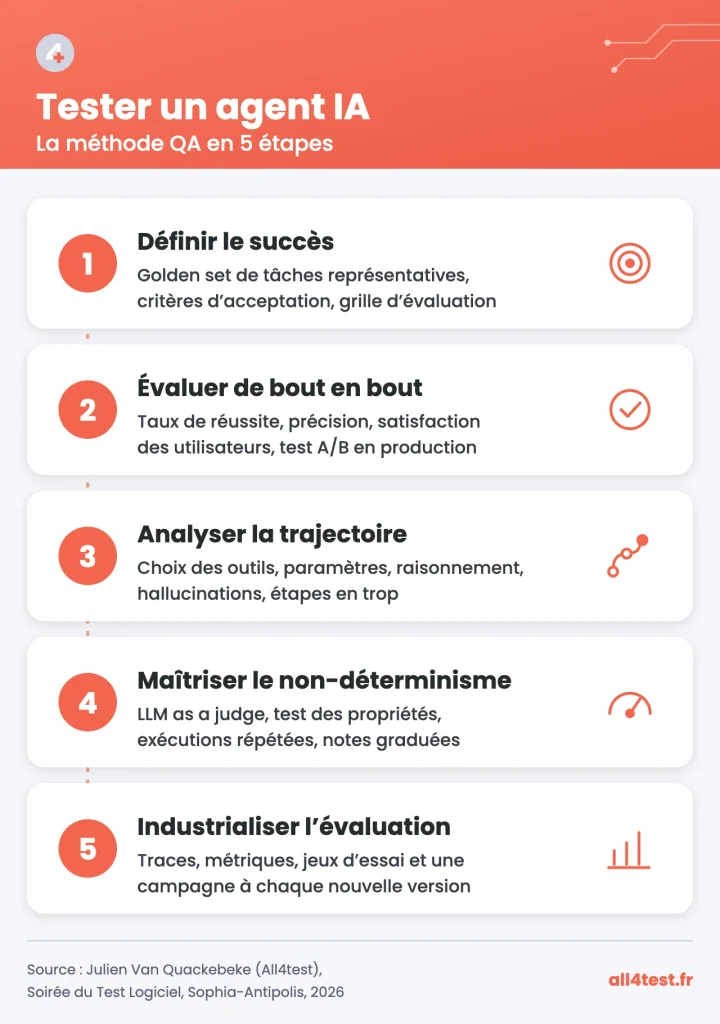
La stratégie part de l’extérieur. Vous testez le résultat en boîte noire. Vous ouvrez la boîte pour comprendre chaque échec.
1. Définir le succès avant le premier test
Tout part de la valeur que l’agent doit délivrer. Constituez un « golden set » : un jeu de tâches utilisateur représentatives, avec leurs critères d’acceptation et une grille d’évaluation. Fixez vos critères de sortie, par exemple : aucune régression sur les 50 tâches principales.
Construisez ce jeu de référence avec les utilisateurs clés. Des ateliers avec eux révèlent les tâches qui comptent et les réponses jugées acceptables. Complétez-le avec des données générées par IA pour couvrir plus de cas.
2. Évaluer la tâche de bout en bout
Lancez le golden set et mesurez le résultat, sans regarder l’intérieur de l’agent. Quatre indicateurs reviennent dans la plupart des projets :
- le taux de réussite des tâches, binaire ou noté ;
- l’exhaustivité et la précision des réponses sur des tâches délimitées ;
- la satisfaction des utilisateurs, par pouce levé ou par note ;
- les indicateurs d’usage, comme le taux d’acceptation des résultats.
En production, un test A/B compare deux versions de l’agent sur les résultats réels des utilisateurs.
3. Ouvrir la boîte : trajectoire et composants
Quand une tâche échoue, la réponse finale n’en donne pas la cause. « Lorsqu’un agent échoue, vous déboguez le chemin, pas seulement la réponse », résume Julien Van Quackebeke. Les traces d’exécution révèlent quatre défauts types :
- un mauvais choix d’outil ou des paramètres incorrects (schéma JSON invalide) ;
- un raisonnement qui dérive ;
- une hallucination ou un contexte pollué ;
- un excès d’étapes ou de reprises, qui fait grimper le coût et la latence.
Testez chaque composant isolé : la planification, l’appel des outils, la mémoire. Un agent qui puise dans une base documentaire (RAG) demande des tests dédiés de la recherche d’information. Notre article RAG : une solution pour améliorer l’efficacité de l’IA dans vos tests logiciels détaille ce mécanisme.
4. Maîtriser le non-déterminisme
Une exécution isolée ne prouve rien. Quatre techniques remplacent la comparaison exacte :
- LLM ou agent « as a judge » : un second modèle note l’exactitude, la pertinence et l’exhaustivité de la réponse, sur la similarité sémantique ;
- test basé sur les propriétés : vous vérifiez les caractéristiques de la sortie (JSON valide, limite de caractères, ton approprié) ;
- mesure de la variabilité : vous répétez chaque test et suivez la note moyenne, les seuils de variance et les intervalles de confiance ;
- seuils gradués : une échelle de notation remplace le verdict réussi ou échoué.
Voici l’échelle présentée par Julien Van Quackebeke :
| Note | Verdict |
|---|---|
| 0,8 à 1,0 | Réussite |
| 0,5 à 0,8 | Avertissement |
| Moins de 0,5 | Échec |
Gardez une évaluation humaine sur un échantillon. Elle capte le ressenti de l’utilisateur ; l’évaluation par IA étend le nombre de cas testés. Les deux se complètent.
5. Industrialiser avec une infrastructure de test dédiée
Chaque nouvelle version du modèle, du prompt ou de l’architecture change le comportement de l’agent. Chaque changement appelle une campagne d’évaluation. Une infrastructure dédiée vous permet de :
- enregistrer les traces d’exécution de l’agent ;
- calculer les métriques et les publier dans un tableau de bord ;
- maintenir les jeux d’essai représentatifs ;
- comparer les architectures et les versions de l’agent ;
- mesurer sa progression d’une version à l’autre.
Procédez par itérations courtes : évaluation, adaptation, réévaluation.
Besoin d’un coach pour mettre en place ces pratiques ?
Avec le Pack IA & Test d’All4test, vos équipes PO, DEV et QA suivent la formation ISTQB CT-GenAI et travaillent avec un coach IA, en ateliers et sur un projet pilote. Le Pack Advanced ajoute un audit préalable, des experts dédiés et un reporting KPI et ROI.
Comment faire un stress test d’un agent IA ?
Le stress test cible la robustesse et la sécurité, deux piliers hors de portée des tâches nominales. Construisez des scénarios hostiles ou ambigus :
- des demandes incomplètes, pour vérifier que l’agent pose une question de clarification ;
- des outils en panne ou lents, pour observer les reprises et la dégradation progressive ;
- des injections de prompt, directes ou cachées dans un document ou une page web ;
- des demandes hors périmètre, pour contrôler le respect des garde-fous.
Le Top 10 de l’OWASP pour les applications LLM recense les failles à couvrir, avec l’injection de prompt en tête. Surveillez le coût : un agent qui boucle multiplie les appels au modèle et la facture.
Faut-il tester la supervision humaine ?
Oui. La supervision humaine fait partie du système : elle se teste comme le reste. Elle prend trois formes :
- synchrone : l’humain valide chaque action sensible avant son exécution ;
- asynchrone : l’humain revoit les preuves d’exécution une fois la tâche finie ;
- hybride : les deux, selon le niveau de risque de l’action.
Vérifiez trois points : l’agent demande l’accord au bon moment, il s’arrête quand l’humain refuse, et l’humain dispose des éléments pour trancher. Pour les systèmes à haut risque, l’article 14 de l’AI Act exige une supervision humaine, avec la possibilité d’ignorer ou d’annuler la décision de l’IA.
Quelles règles s’appliquent aux agents IA en 2026 ?
Un agent IA fait partie de votre système d’information. Il entre dans le périmètre de vos normes et de vos obligations. Trois repères en octobre 2026 :
- l’article 50 de l’AI Act s’applique depuis le 2 août 2026 : un agent qui échange avec des personnes doit leur indiquer qu’elles parlent à une IA ;
- le règlement (UE) 2026/1744 reporte les exigences des systèmes à haut risque (recrutement, crédit, éducation) au 2 décembre 2027, et au 2 août 2028 pour l’IA intégrée à des produits réglementés ;
- la norme ISO/IEC 42001:2023 définit le système de management de l’IA de l’entreprise.
Les obligations dépendent de votre rôle. Le fournisseur documente les capacités et les limites de l’agent et gère ses risques. Le déployeur qualifie le niveau de risque selon l’usage réel, organise la supervision humaine et vérifie la conformité des agents tiers. Pour l’équipe de test, chaque obligation devient un cas de test.
Deux retours d’expérience : que montrent les chiffres ?
Julien Van Quackebeke a présenté deux agents évalués avec cette méthode (support de la conférence, PDF).
Un agent de conception de tests avec RAG
L’agent met à jour un parcours de test à partir de nouvelles user stories. Il puise ses connaissances dans une base documentaire (RAG). Il produit des modèles graphiques de test et des tables de conditions de test. Un humain valide chaque action : la supervision est synchrone.
Les tests en chiffres :
- 350 items dans le jeu de données de test du RAG, dont 50 écrits par des humains et 300 générés par IA ;
- 5 projets exemples pour tester la création de parcours de test ;
- 4 ateliers avec des utilisateurs clés.
Le RAG passe par un « jeu de vérité » : un expert métier pose des questions et classe chaque réponse en correcte, approximative, erronée ou incomplète. Enseignement : les jeux de données générés par IA ont permis une forte progression de l’agent.
Un agent d’exécution des tests fonctionnels
L’agent exécute les étapes de test sur l’interface et vérifie le résultat attendu sur des captures d’écran. Il commente chaque étape et rend un verdict. Le testeur QA lance les exécutions et valide le rapport : la supervision est asynchrone.
Les tests en chiffres :
- plus de 700 scénarios de test représentatifs, sur plus de 50 applications ;
- plus de 100 campagnes d’évaluation en 18 mois, pour comparer les architectures et les versions de l’agent ;
- 12 sessions suivies avec des utilisateurs pilotes.
Ce volume repose sur l’infrastructure de test de l’étape 5 : un pilote, un harnais de test, les jeux d’essai et les traces d’exécution.
Questions fréquentes sur le test des agents IA
Un second modèle de langage évalue la réponse de l’agent testé. Il la note sur des critères définis : exactitude, pertinence, exhaustivité. La méthode traite des milliers de cas ; un échantillon évalué par des humains sert à calibrer le juge.
Oui : le golden set, les métriques, le juge IA et les campagnes d’évaluation s’automatisent. L’évaluation humaine garde sa place sur un échantillon, pour mesurer la qualité ressentie et contrôler le juge.
Testez la recherche d’information et la génération de réponse chacune de son côté. Un expert métier pose des questions dont il connaît la réponse et classe chaque réponse : correcte, approximative, erronée ou incomplète. Des questions générées par IA élargissent la couverture.
L’ISTQB propose deux certifications : CT-AI pour tester les systèmes d’IA, CT-GenAI pour tester avec l’IA générative. All4test prépare à la certification ISTQB CT-GenAI, en intra ou en visioconférence.
Vous déployez un agent IA ?
Vous voulez savoir si votre agent prend les bonnes décisions ? Nos experts QA vous aident à poser votre stratégie de test : golden set, métriques, supervision humaine.
Vous préférez faire monter vos équipes en compétence ? Découvrez la formation ISTQB CT-GenAI : tester avec l’IA générative.
Voir aussi :
- Comment tester un agent IA ? Le compte rendu de la conférence de Julien Van Quackebeke
- Agents IA en test logiciel : cas d’usage et bénéfices
- Top 5 des meilleurs agents IA pour optimiser vos tests logiciels
- IA générative pour les tests logiciels : introduction
Sources :
- Julien Van Quackebeke, « Comment tester un agent IA ? », Soirée du Test Logiciel, Sophia-Antipolis, 15 septembre 2026 (support PDF).
- Règlement (UE) 2024/1689 sur l’intelligence artificielle (AI Act), articles 14 et 50.
- Règlement (UE) 2026/1744, omnibus numérique sur l’IA.
- ISO/IEC 42001:2023, systèmes de management de l’intelligence artificielle.
- OWASP Top 10 for LLM Applications 2025.
- ISTQB, Certified Tester AI Testing (CT-AI).